blog シナモンブログ
【第8回】Super RAG API活用事例:文書を FAQ に作り替える — 「その FAQ、誰が作るんですか?」への答え
- はじめに
- 本連載について
- 業務シーン — 社内 IT サポートの「同じ質問」問題
- RAG があれば FAQ は不要では?
- なぜ FAQ 整備は進まないのか
- FAQ Builder のアーキテクチャ — 6つのフェーズ
- 設計思想① evidence-first — 根拠を捨てない
- 設計思想② 全文を対象にする — あえて検索に頼らない
- 設計思想③ レビュー前提 — 完全自動化しないという判断
- 4つの画面で回す運用フロー
- 用語集との関係 — FAQ と辞書は役割が違う
- 出口は2つ — FAQ 管理ソフトへ、あるいは RAG へ
- ストーリーの続き — Kさんの業務はどう変わったか
- 【持ち帰り検討材料】FAQ 化候補文書の棚卸しシート
- 次回予告
- まとめ
はじめに
本記事のメッセージ:第6回で「用語集を登録しておけば、Super RAGが自動的に効かせてくれる」とお伝えしました。ただ、その先に必ず出てくる問いがあります——「では、その FAQ は、誰がいつ作るのか」。本記事では、この問いに正面から答えます。ただしその前に、「RAG があるなら FAQ は要らないのでは?」という、もう一段手前の疑問にもお答えします。鍵になるのは、「文書をそのまま検索させる」のではなく、知識の形そのものを Q&A に作り替えておくという発想の転換です。そのうえで、文書はあるのに FAQ が整備されない構造的な理由を分解し、文書群から FAQ を半自動で立ち上げるアプローチをご紹介します。なお、FAQ と用語集の役割の違いは、後半の「用語集との関係」で整理します。
ある企業で社内 IT ヘルプデスクを担当している Kさんを思い浮かべてください。従業員800名規模の会社で、情報システム部の中の3名体制。日々寄せられる問い合わせは、1日あたり30〜50件ほどです。
「VPNに繋がらない」「経費精算システムのパスワードを忘れた」「新しいノートPCの初期設定手順を教えてほしい」「共有フォルダのアクセス権を追加したい」——内容は多岐にわたりますが、Kさんには薄々わかっていることがあります。この問い合わせの大半は、過去に誰かが同じことを聞いている、ということです。
そして、答えは社内文書のどこかに、たいてい書いてあります。運用マニュアル、システム管理者ガイド、導入時の手順書、過去のインシデント対応記録。「文書はある」のです。それなのに、問い合わせは減りません。
Kさんは何度も思ってきました。「FAQ を整備すれば、この状況は変わるはずだ」。実際、上長からもそう言われています。ただ、実行に移せていません。理由はシンプルで、FAQ を作る時間がないからです。日々の問い合わせ対応に追われて、腰を据えて文書を読み込み、FAQ の形に整理する時間が取れない。これが3年続いています。
本連載について
本記事は第8回です。連載は、(I)なぜSuper RAG、(II)どう組み込むか、(III)中身を可視化、(IV)現場で何が起きているか、(V)導入判断、という5章構成で進めています。第IV章「現場で何が起きているか」の2本目にあたり、前回(第7回)の製造業・安全管理の事例に続いて、今回は社内 IT サポートの現場を舞台にします。
本記事は、第6回でご紹介した Dictionary 前処理の”宿題”に答える回でもあります。第6回では「用語集を登録すれば自動的に効く」という運用上の利点をお伝えしましたが、その用語集や FAQ をどうやって用意するかについては触れていませんでした。今回はそこを扱います。
アーキテクチャとしては、第2回でご紹介した3つの組み込みパターンのうちパターン②(検索特化)にあたります。前回と同じパターンですが、用途がまったく異なります。前回が「検索の入口を文書にする」というリアルタイム用途だったのに対し、今回は「知識の形そのものを作り替える」というバッチ用途です。同じパターンの中に、これだけ違う使い方が入る——という点も、あわせてご覧いただければと思います。
業務シーン — 社内 IT サポートの「同じ質問」問題
Kさんのチームに寄せられる問い合わせを、実際に分類してみるとどうなるでしょうか。多くのヘルプデスク組織で共通して見られる構造があります。
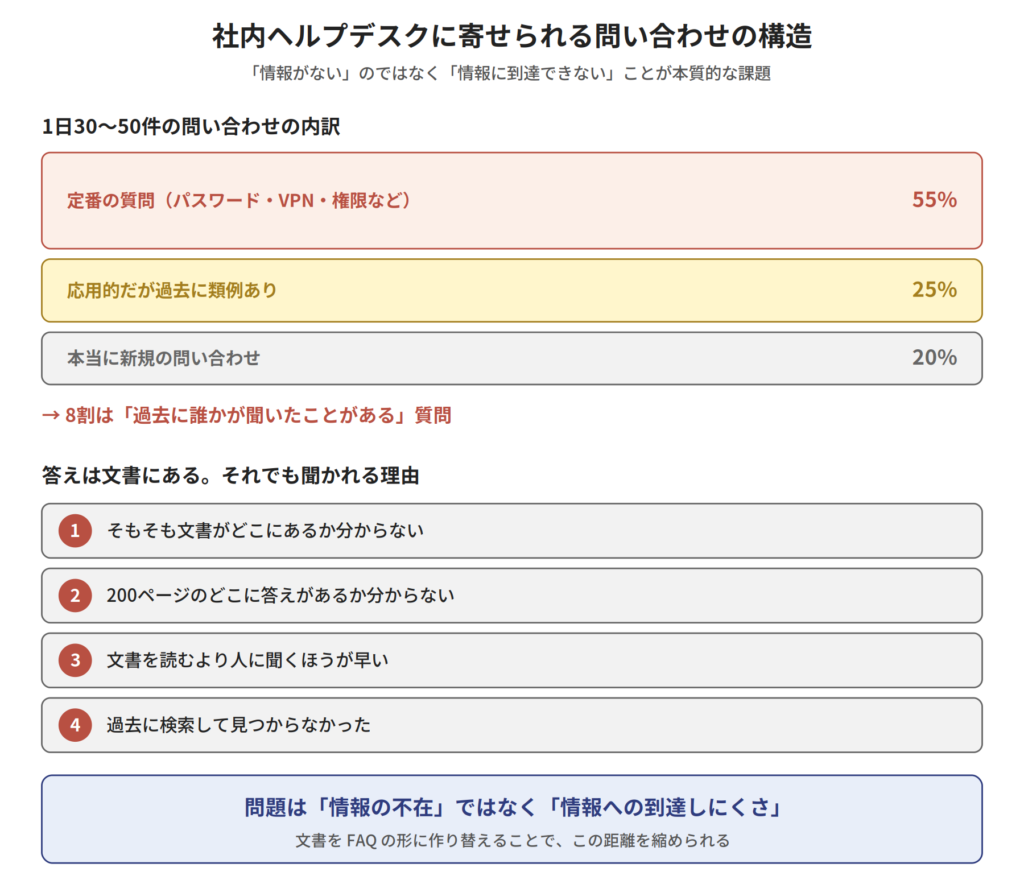
社内ヘルプデスクに寄せられる問い合わせの構造
1. 既出の質問が大半を占める
パスワードリセット、VPN接続、プリンタ設定、共有フォルダの権限、ソフトウェアのインストール申請——こうした「定番」の問い合わせが、件数ベースで大きな割合を占めます。内容としては過去に何度も答えているものです。
2. 答えは文書に書いてある
しかも、その答えは社内のどこかに文書として存在します。IT部門が作成した運用マニュアル、ベンダーから提供された管理者ガイド、システム導入時に作られた手順書。「情報がない」わけではありません。
3. それでも問い合わせは来る
なぜでしょうか。理由はいくつも重なっています。
- 利用者は、その文書がどこにあるか知らない
- 文書を開いても、200ページの中のどこに答えがあるか分からない
- そもそも、文書を読むより人に聞くほうが早いと判断している
- 過去に検索して見つからなかった経験があり、最初から諦めている
つまり、問題は「情報の不在」ではなく「情報への到達しにくさ」です。
4. ヘルプデスク側の疲弊
Kさんの立場からすると、同じ説明を繰り返すことに徒労感があります。加えて、対応品質が担当者によってばらつくという問題もあります。ベテランのAさんが答えると的確だが、新人のBさんが答えると回り道になる。組織としての回答が標準化されていないのです。
そして最も深刻なのは、この状況を改善するための時間が、日々の対応で埋まってしまっていることです。FAQ を作れば楽になるとわかっているのに、作る時間がない。典型的な悪循環です。
RAG があれば FAQ は不要では?
ここで、自然な疑問が湧きます。「そもそも RAG を導入すれば、FAQ を作らなくても文書から直接答えられるのでは?」
もっともな疑問です。実際、Super RAG を導入して社内文書を登録すれば、「VPNに繋がりません」と聞くだけで、関連する記述を引いて回答してくれます。これは大きな前進です。
ただし、RAG だけでは届きにくい領域があるのも事実です。3つの構造的な理由があります。
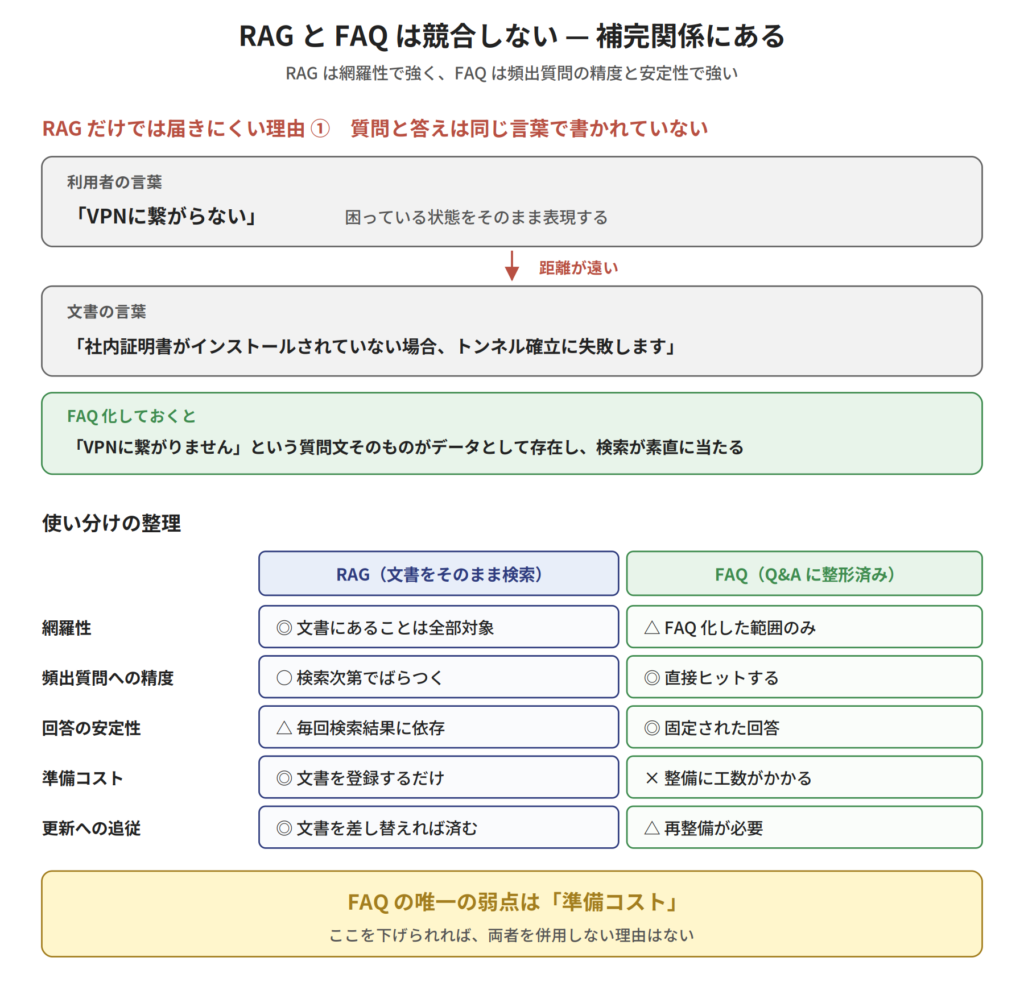
RAG と FAQ の補完関係
理由1:質問と答えは、同じ言葉で書かれていない
RAG の検索は、質問文と文書チャンクの「近さ」で候補を選びます。第5回でご紹介したハイブリッド検索により、意味の近さと語の一致の両面から拾えるようになっていますが、それでも根本的なギャップが残ります。
利用者は「VPNに繋がらない」と聞きます。しかし文書には「リモートアクセス環境の接続性に関する前提条件」と書いてある。あるいは「社内証明書がインストールされていない場合、トンネル確立に失敗します」と書いてある。人間なら同じことだと分かりますが、検索の距離としては必ずしも近くありません。
FAQ 化されていれば、この変換はあらかじめ済んでいます。「VPNに繋がりません」という質問文そのものがデータとして存在するので、検索は素直に当たります。
理由2:答えが複数文書に散らばっている
実務では、1つの問いに対する答えが、複数の文書・複数のページに分散しているのは珍しくありません。RAG は関連チャンクを複数引いてきますが、引いたチャンクを毎回その場で統合することになります。
これは可能ではありますが、毎回の回答生成でその統合をやり直しているとも言えます。統合の質は、その時の検索結果に依存します。もし重要な1文が検索で拾えなければ、その回答からは抜け落ちます。
FAQ 化しておけば、統合は一度きりです。しかも、後述するようにレビューを経ているので、抜け漏れがあれば人が気づけます。
理由3:どこが「答え」なのか、文書は教えてくれない
文書は、FAQ として書かれていません。仕様書は仕様を、マニュアルは操作手順を、それぞれの論理で構成されています。「利用者がよく困る点」という観点では整理されていないのです。
FAQ 化は、この観点の転換を行う作業です。文書の論理から、利用者の論理へ。この変換こそが、FAQ の価値の本体です。
結論:RAG と FAQ は補完関係
つまり、RAG と FAQ は「どちらか」ではなく「どちらも」です。
| RAG(文書をそのまま検索) | FAQ(Q&A に整形済み) | |
|---|---|---|
| 網羅性 | ◎ 文書に書いてあることは全部対象 | △ FAQ 化した範囲のみ |
| 頻出質問への精度 | ○ 検索次第でばらつく | ◎ 直接ヒットする |
| 回答の安定性 | △ 毎回検索結果に依存 | ◎ 固定された回答 |
| 準備コスト | ◎ 文書を登録するだけ | × 整備に工数がかかる |
| 更新への追従 | ◎ 文書を差し替えれば済む | △ 再整備が必要 |
RAG は網羅性で強く、FAQ は頻出質問の精度と安定性で強い。理想は、頻出領域を FAQ でカバーし、それ以外を RAG が受け止める構成です。
そして、この表の中で FAQ の唯一の弱点が「準備コスト」です。ここさえ解消できれば、両者を併用しない理由はありません。本記事の主題は、まさにこの準備コストをどう下げるかです。
なぜ FAQ 整備は進まないのか
では、その「準備コスト」の正体は何でしょうか。「FAQ を作ればいい」——言うのは簡単ですが、実際に手を動かすと、想像以上に手間がかかります。Kさんが過去に一度だけ着手して、途中で断念した経験を分解してみましょう。
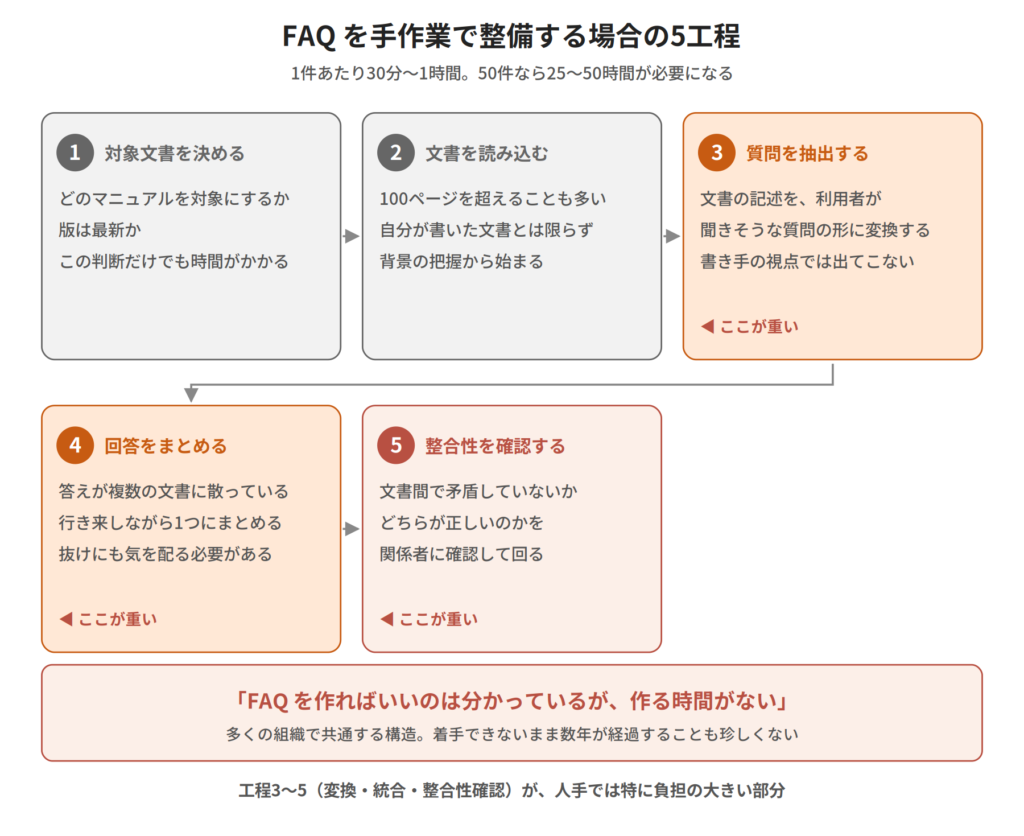
FAQ を手作業で整備する場合の5工程
工程1:対象文書を決める
まず、どの文書から FAQ を起こすかを決めます。運用マニュアルは10種類以上あり、うち3つは版が古い。どれを対象にすべきか、判断そのものに時間がかかります。
工程2:文書を読み込む
対象を決めたら、実際に読みます。1つの運用マニュアルが100ページを超えることも珍しくありません。しかも、Kさん自身が全部を熟知しているわけではない。他部署が作った文書、前任者が残した文書も含まれます。
工程3:質問を抽出する
読みながら、「ここは FAQ になりそうだ」という箇所を拾い上げます。ここが最も知的な作業で、文書の記述を「利用者が聞きそうな質問」の形に変換する必要があります。
たとえば文書に「VPNクライアントの初期設定においては、社内証明書のインストールが前提となる」と書いてあったとします。これを FAQ にするなら、質問は「VPNに接続できません。何を確認すればいいですか?」でしょうか。それとも「VPNの初期設定手順を教えてください」でしょうか。元の記述と、利用者の言葉は、そもそも一致していません。
工程4:回答をまとめる
質問が決まったら、回答を書きます。ここでよくあるのが、答えが1箇所に書いていないという問題です。VPN接続の手順は運用マニュアルに、証明書の取得方法は別の手順書に、トラブル時の対処は過去のインシデント記録に——というように、複数の文書に散らばっているのが普通です。これらを1つの回答にまとめるには、複数文書を行き来する必要があります。
工程5:整合性を確認する
さらに厄介なのが、文書間で記述が食い違っているケースです。古いマニュアルと新しい手順書で手順が違う。部署によって運用が異なる。こうした矛盾を見つけて、どちらが正しいかを判断し、必要なら関係者に確認する——ここまでやって、ようやく1件の FAQ が完成します。
結果:1件あたり30分〜1時間
Kさんの体感では、きちんとした FAQ を1件作るのに、平均して30分から1時間かかりました。50件作ろうとすれば、25〜50時間。日々の業務の合間にこれを捻出するのは、現実的ではありませんでした。
これが、「FAQ を作ればいいのはわかっているが、作れない」の実態です。そして、この構造はどの組織にも共通しています。
FAQ Builder のアーキテクチャ — 6つのフェーズ
Cinnamon AI では、Super RAG の API を活用したデモアプリケーションとして「FAQ Builder」を開発しています。文書群から FAQ を半自動生成し、レビューを経て公開できる機能です。
前回(第7回)でご紹介した「文書 vs 文書」検索と同じく、Super RAG を部品として使い、上位のロジックを自社で組み立てるパターン②の構成です。ただし用途は大きく異なり、こちらはリアルタイムの検索ではなく、知識データを作り替えるバッチ処理にあたります。
処理は6つのフェーズに分かれています。単に「文書を LLM に渡して FAQ を作らせる」のではなく、工程を分けることに設計上の意味があります。
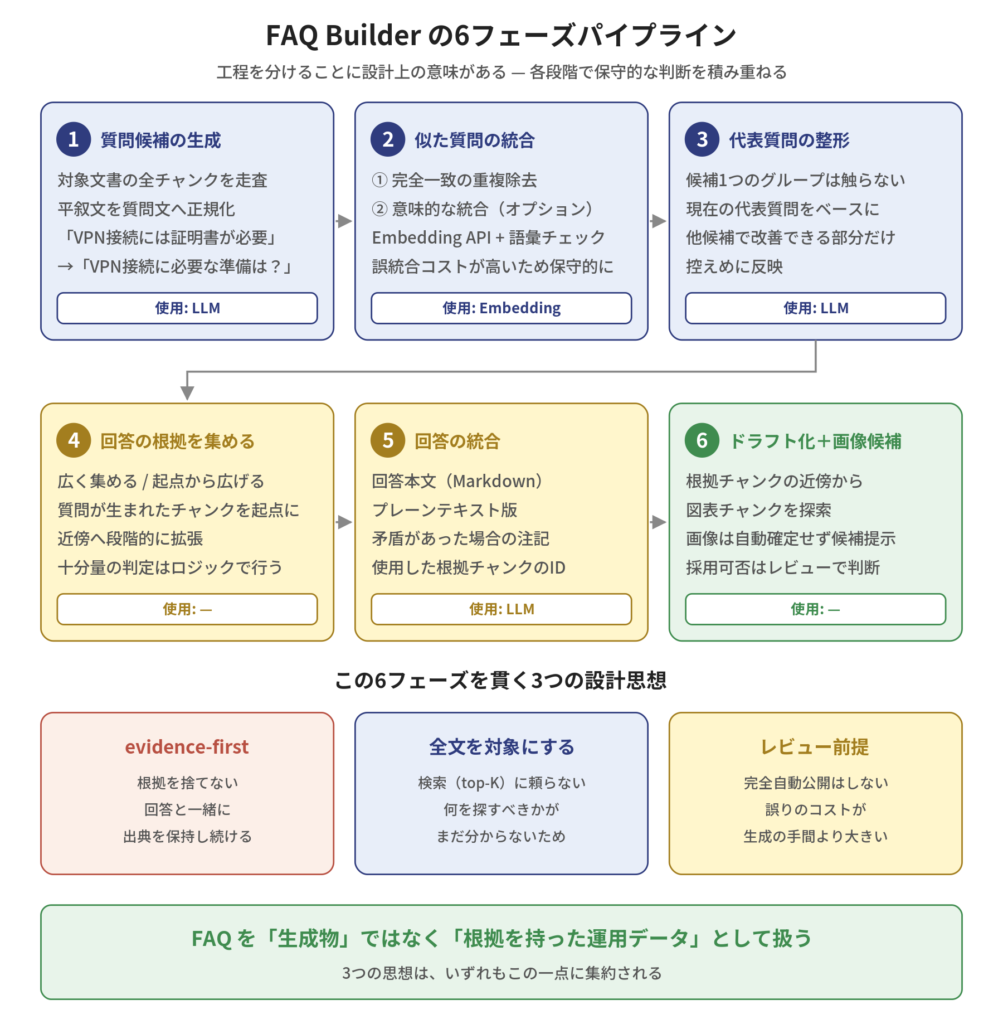
FAQ Builder の6フェーズパイプライン
フェーズ1:質問候補の生成
まず、対象文書の全チャンクを走査して、質問候補を作ります。文書に書かれている記述から、「これは質問として成立しそうだ」というものを拾い上げる工程です。
ここで重要なのが、平叙文を質問文に正規化する機能です。文書には「VPN接続には社内証明書が必要です」と書いてあります。これをそのまま検索対象にするのではなく、「VPN接続に必要な準備は何ですか?」という質問文に変換します。先にお話しした「文書の論理から利用者の論理へ」の変換が、ここで行われます。
この変換をどこまで積極的に行うかは、設定で制御できます。
- 控えめモード:文書に明示的な問いや、それに近い見出しがある箇所を中心に FAQ 化
- 積極モード:見出し・説明文・手順名なども、幅広く質問文へ変換
マニュアルや提案資料のように「問いの形では書かれていないが、内容としては FAQ になる」文書では、積極モードが有効です。
フェーズ2:似た質問の統合
全文を走査すると、似たような質問候補が大量に出てきます。「VPNの接続方法は?」「VPNにはどうやって繋ぐ?」「リモート接続の手順は?」——これらは実質的に同じ質問です。
そこで、質問候補を統合します。ただし、ここには慎重さが必要です。
FAQ において、誤った統合のコストは非常に高いからです。似ているようで条件が違う2つの質問を1つにまとめてしまうと、片方の条件が回答から抜け落ちます。利用者はそれに気づかず、誤った手順を実行してしまうかもしれません。
そのため、統合は2段階で、しかも保守的に行われます。
- 完全一致・ほぼ一致の重複除去:まず、明らかに同じ質問だけを機械的にまとめる
- 意味的な統合(オプション):Super RAG の Embedding API を使って意味の近さを測り、加えて語彙の一致もチェックしたうえで、保守的に統合する
「いきなり意味の近さだけで統合しない」——これがこの設計の要点です。第5回でご紹介した意味と語の両輪という発想が、ここでも効いています。
フェーズ3:代表質問の整形
統合されたグループには、複数の質問候補が含まれています。この中から代表となる質問文を選び、必要に応じて整えます。
ここでも保守的な方針が採られています。
- 候補が1つしかないグループには、この処理を適用しない(触る必要がないため)
- 複数候補があるグループでも、現在の代表質問をベースにする
- 他の候補で表現が改善できる部分だけを、控えめに反映する
「複数の質問を合成して新しい質問を作る」のではなく、「既にある質問を、より自然な表現に微修正する」という位置づけです。無理な合成で不自然な質問文が生まれるのを防ぐ設計です。
フェーズ4:回答の根拠を集める
質問が確定したら、次は回答の材料集めです。ここがコストと網羅性のトレードオフが最も強い部分になります。
FAQ Builder では2つのモードを用意しています。
広く集めるモード:質問に関連する文書群から、幅広く根拠を集めます。網羅性は高いですが、処理量も増えます。
起点から広げるモード:その質問がどのチャンクから生まれたかを起点にして、同じ文書内の近傍チャンクへ段階的に範囲を広げます。一定量の根拠が集まった時点で停止します。
後者の設計で興味深いのは、「十分な根拠が集まったか」の判定に LLM を使っていない点です。チャンク数や文字数といった、機械的に測れる基準で判定します。コスト削減のための判定処理で、余計なコストを発生させない——という思想が現れています。
フェーズ5:回答の統合
集めた根拠をもとに、回答を組み立てます。出力されるのは回答文だけではありません。
- 回答本文(Markdown 形式)
- プレーンテキスト版(外部システムへの受け渡し用)
- 矛盾があった場合の注記
- 実際に使用した根拠チャンクの ID 一覧
最後の「使用した根拠チャンクの ID」を出力させているのが、この設計の肝です。これがあることで、後の工程で「この回答は文書のどこに基づいているか」を正確に辿れます。次節で詳しくご説明します。
フェーズ6:ドラフト化と画像候補の付与
最後に、生成された Q&A をドラフトとして保存します。あわせて、回答に関連しそうな図や画像の候補も提示されます。
仕組みはこうです。フェーズ5で得た「使用した根拠チャンクの ID」から、その近くにある図表チャンクを探します。第4回でご紹介した DocReader の構造保持により、文書内の図は位置情報を持ったまま保存されているので、「この記述の近くにあった図」を特定できます。
ただし、画像は自動確定されません。あくまで「候補」として提示され、レビュー担当者が採用するかどうかを判断します。マニュアル類では図が理解を大きく助けるため、この機能は効果的ですが、無関係な図が紛れ込むリスクもあるためです。
設計思想① evidence-first — 根拠を捨てない
ここから、FAQ Builder の設計を貫く3つの思想をご紹介します。いずれも「FAQ を生成物として扱わない」という一点に集約されます。
最初は evidence-first です。生成された FAQ は、単なるテキストではなく、根拠情報を持ったデータとして保存されます。
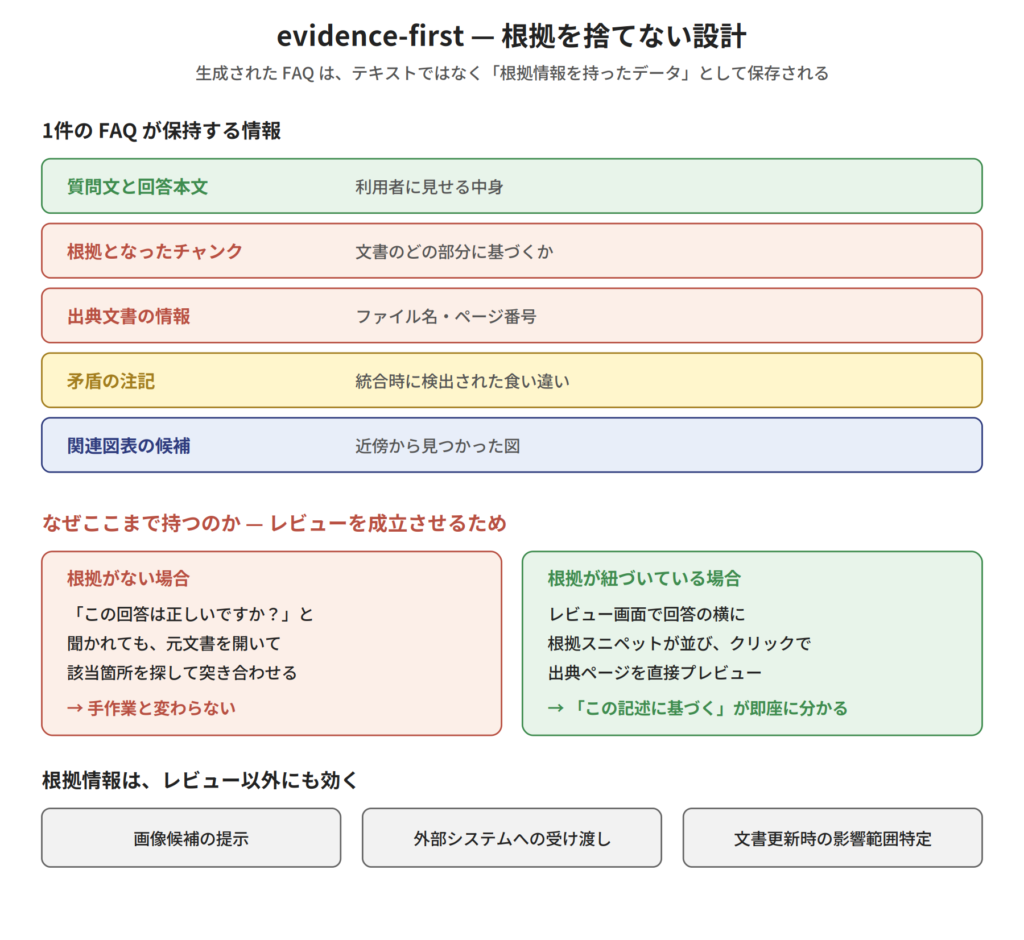
evidence-first の構造
具体的には、1件の FAQ が次の情報を保持します。
- 質問文と回答本文
- 回答の根拠となったチャンク(文書のどの部分か)
- 出典文書の情報(ファイル名、ページ)
- 統合時に検出された矛盾の注記
- 関連する図表の候補
なぜここまで持つのでしょうか。レビューを成立させるためです。
生成された回答だけを見せられて「これは正しいですか?」と聞かれても、判断はできません。元の文書を開いて、該当箇所を探して、突き合わせる——それでは手作業と変わりません。
根拠が紐づいていれば、話は変わります。レビュー画面で回答の横に根拠スニペットが並び、クリックすれば出典文書の該当ページがプレビュー表示される。PDF なら該当ページを狙って開き、Office 文書ならキャッシュされたプレビューを表示します。「この回答は、この文書のこの記述に基づいている」が即座に確認できるわけです。
これは第6回でご紹介した Inline citation highlight と同じ発想です。あちらはチャット回答の根拠を文単位で追跡可能にする機能でしたが、こちらは FAQ 生成における根拠追跡。Super RAG のプロダクト全体を貫く「根拠を示す」という思想が、ここでも現れています。
そしてこの evidence 情報は、レビュー以外にも効きます。
- 画像候補の提示:根拠チャンクの近傍から図を探せる
- 外部システムへの受け渡し:出典情報を含めてエクスポートできる
- 将来の再処理:文書が更新されたとき、影響範囲を特定できる
「根拠を捨てない」という判断が、後続のあらゆる機能の土台になっています。
設計思想② 全文を対象にする — あえて検索に頼らない
2つ目の思想は、少し意外に感じられるかもしれません。FAQ Builder は、質問生成の段階で検索(top-K retrieval)を使っていません。対象文書の全チャンクを走査します。
RAG の文脈では「関連する上位K件を引く」のが定石です。なぜここではそうしないのでしょうか。
理由は、FAQ を作る段階では「何を探すべきか」がまだ分かっていないからです。
通常の RAG は、質問が先にあります。質問があるから、それに近いものを探せます。ところが FAQ 生成では、その質問自体をこれから作るのです。「何を FAQ にすべきか」を決めるために検索しようとしても、検索キーがありません。
仮に「よくある質問」のような一般的なキーワードで検索したとしても、文書中の重要な記述が上位に来る保証はありません。むしろ、FAQ 化すべき「うっかり見落としがちな例外条件」ほど、検索では拾いにくい可能性があります。
そこで FAQ Builder は、全文を見るという素直な方針を採ります。網羅性を最優先し、コストは別の手段で最適化するという設計判断です。
その「別の手段」が、前節で触れた根拠の集め方の工夫です。
- 起点から広げるモード:質問が生まれた場所を起点に、必要十分な範囲だけ根拠を集める
- 中間表現の活用(オプション):文書の要点をあらかじめ構造化して保持し、回答生成時に全チャンクを再送しなくて済むようにする
つまり、「全文を対象にする」という原則は守りつつ、無駄な再処理を減らすという方向でコストを抑えています。網羅性を犠牲にしてコストを下げるのではなく、網羅性を保ったまま効率を上げる——という順序です。
加えて、実行前にコストの上限が見える仕組みも用意されています。
- AI の呼び出し回数の上限
- 入力・出力トークンの上限
- 生成される質問候補の上限
これらを実行前に表示します。厳密な予測ではなく上限値ですが、「気づいたら想定外のコストがかかっていた」という事故を防ぐには十分です。対象文書を広げすぎたときに、走らせる前に気づける——運用上、これはかなり重要な機能です。
設計思想③ レビュー前提 — 完全自動化しないという判断
3つ目は、おそらく最も重要な思想です。FAQ Builder は、完全自動での FAQ 公開を想定していません。生成されたものは必ず「ドラフト」であり、人のレビューを経てから公開されます。
これは技術的な限界ではなく、意図的な設計判断です。
FAQ は、社内の公式な回答として扱われます。誤った FAQ が公開されれば、それを信じた利用者が誤った操作をします。誤りのコストが、生成の手間より大きい——この判断が、レビュー必須という設計につながっています。
レビュー担当者は、各 FAQ に対して4つの判定を行えます。
| 判定 | 意味 |
|---|---|
| 承認 | この FAQ を公開する |
| 却下 | 内容に誤りがある |
| 不要 | 内容は正しいが、FAQ としては採用しない |
| 保留 | 判断を後回しにする |
注目していただきたいのが「不要」です。「間違っている」のではなく「FAQ にする必要がない」という判定を、独立した選択肢として持っています。
実務では、この区別が効きます。生成された Q&A の中には、内容としては正しいが、「そんなことを質問する人はいない」というものが混じります。これを「却下」で処理してしまうと、後から見返したときに「何か問題があったのか」と誤解されます。「不要」という判定があることで、棚卸しの記録として正確に残せるわけです。
レビューの実務では、質問文よりも回答と根拠の妥当性確認が重要になります。質問文が多少不自然でも実害は小さいですが、回答が誤っていれば実害があるためです。そのため、レビュー画面は根拠の確認をしやすい構成——回答の横に根拠スニペットが並び、クリックで出典プレビューに飛べる——になっています。
また、レビューを通った FAQ は「バージョン単位で固定」されます。公開後に元の文書が更新されても、公開済み FAQ は自動では書き換わりません。元文書が更新されると、ドラフトは「古くなった」状態としてマークされ、再生成 → 再レビュー → 再公開という手順を踏みます。
一見面倒に思えますが、これも運用の安定性を優先した判断です。知らないうちに公開中の FAQ が変わっているという状況は、社内の公式回答としては望ましくありません。
4つの画面で回す運用フロー
ここまでの仕組みは、4つの画面で運用されます。
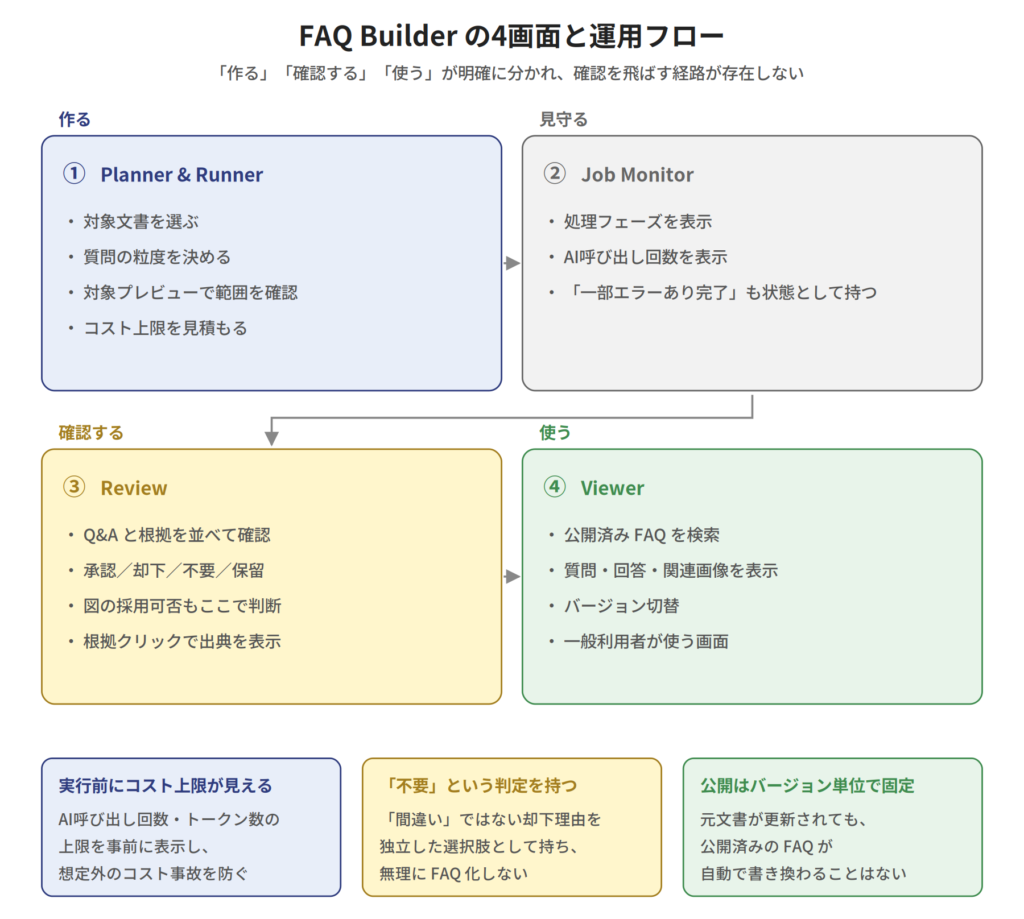
FAQ Builder の4画面フロー
① Planner & Runner — 何を対象に、どう作るかを決める
対象となる文書コレクションを選び、ファイル名パターンで絞り込みます。加えて、生成の方針を設定します。
- 質問の粒度:概要寄り/標準/詳細寄りの3段階
- 平叙文からの変換をどこまで許すか
- ドラフトとして残す上限件数
設定したら、実行前に2つの確認ができます。対象文書のプレビュー(絞り込みが意図通りか)と、コスト上限の見積もり(前節でご紹介したもの)です。両方を確認してから実行に移せます。
② Job Monitor — 処理の状況を見る
生成処理は時間がかかるため、進行状況を確認する画面が用意されています。現在どのフェーズにいるか、AI を何回呼び出したか、といった情報が見えます。
ここで特徴的なのが、「一部エラーあり完了」という状態を持っている点です。すべてのフェーズが完璧に終わらなくても、ドラフトが生成できていればその状態として扱い、部分的な成果を捨てません。どのフェーズで何が起きたかは診断情報として残るので、原因の切り分けもできます。
③ Review — 根拠を見ながら承認する
前節でご紹介したレビュー画面です。左側に Q&A の一覧、右側に根拠スニペットと出典プレビュー。根拠を確認しながら、承認・却下・不要・保留を判定していきます。図の候補があれば、採用するかどうかもここで決めます。
④ Viewer — 公開された FAQ を使う
承認された FAQ が公開され、一般利用者が検索・閲覧できる画面です。質問・回答・関連画像が表示され、バージョンの切り替えもできます。
この4画面の順序に、運用の思想が現れています。「作る」と「確認する」と「使う」が明確に分かれており、確認を飛ばして使う経路が存在しません。
用語集との関係 — FAQ と辞書は役割が違う
ここで、第6回の話に戻ります。Dictionary 前処理は「用語集を登録しておけば、検索前にクエリを自動的に標準化してくれる」機能でした。
FAQ と用語集は、どちらも「文書から作る補助データ」ですが、役割はまったく違います。
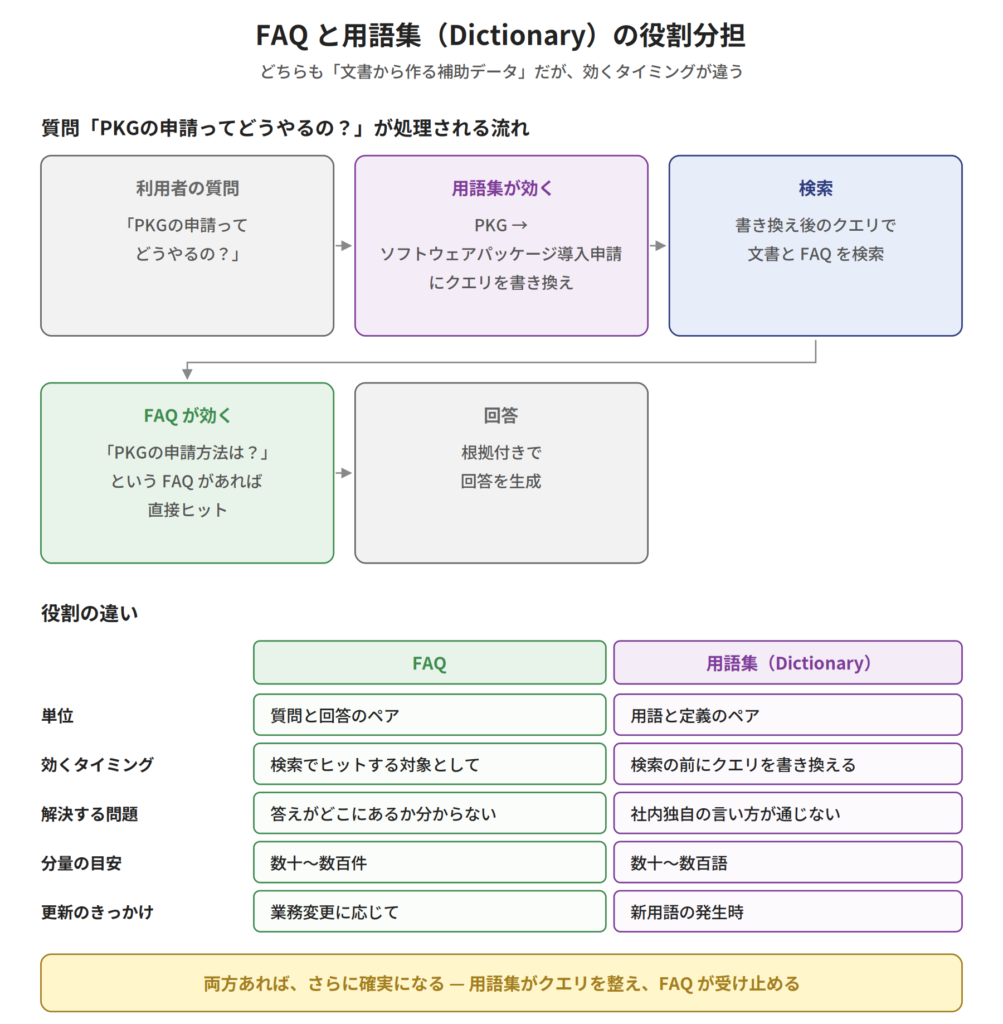
FAQ と用語集の役割分担
| FAQ | 用語集(Dictionary) | |
|---|---|---|
| 単位 | 質問と回答のペア | 用語と定義のペア |
| 効くタイミング | 検索でヒットする対象として | 検索前にクエリを書き換える |
| 解決する問題 | 「答えがどこにあるか分からない」 | 「社内独自の言い方が検索に通じない」 |
| 分量の目安 | 数十〜数百件 | 数十〜数百語 |
| 更新頻度 | 業務変更に応じて | 新用語の発生時 |
具体例で考えてみましょう。Kさんの会社で「PKGの申請ってどうやるの?」という質問が来たとします。
社内では「PKG」が「ソフトウェアパッケージ導入申請」の略称として使われていますが、文書には正式名称で書かれています。このとき、
- 用語集が効く場合:「PKG」を「ソフトウェアパッケージ導入申請」に書き換えてから検索するので、正式名称で書かれた文書に届く
- FAQ が効く場合:「PKGの申請方法は?」という FAQ が既にあれば、直接ヒットする
両方あれば、さらに確実になります。用語集がクエリを整え、FAQ が受け止める。第6回でご紹介した「Dictionary 前処理」と、本記事の FAQ が、この位置関係で連携します。
そして、用語集の整備にも同じ課題があります。「用語集を登録すれば効く」のは事実ですが、その用語集を作るのは人です。社内で使われている略号を洗い出し、正式名称を確認し、表記揺れをまとめる——これも FAQ 整備と同様に、手間のかかる作業です。
FAQ Builder は現時点で FAQ の生成に特化していますが、「文書から補助データを立ち上げる」という発想自体は、用語集にも応用できる方向です。文書中に頻出する略号や専門用語を抽出し、定義を探して、用語集の候補として提示する——という流れは、FAQ 生成とかなり近い構造をしています。
出口は2つ — FAQ 管理ソフトへ、あるいは RAG へ
生成された FAQ の使い道は、大きく2つあります。どちらか一方ではなく、両方に流せるのが FAQ Builder の設計上の特徴です。
出口1:既存の FAQ 管理ソフトへ投入する
多くの企業は、すでに何らかの FAQ 管理システムやナレッジベース製品を使っています。社内ポータル、サービスデスクツール、ヘルプセンター製品——これらに投入するFAQ データの整備として使えます。
この場合、Super RAG は「FAQ を作るための道具」であって、最終的な利用は既存システム上で行われます。既存資産を捨てずに、その中身を充実させるというアプローチです。
出口2:RAG の検索対象として登録する
もう一つは、生成した FAQ をそのまま Super RAG に登録し直す使い方です。ここで第4回の内容が効いてきます。
第4回で「素材の性質に応じて専用のチャンカーが選ばれる」とご紹介し、その中に FAQChunker(Q&A対を1つの単位として扱う)がありました。FAQ Builder が生成したデータは、まさにこの FAQChunker が最も得意とする形式です。
つまり、
- 文書を Super RAG に登録する
- FAQ Builder で FAQ を生成する
- レビューして承認する
- 生成した FAQ を、また Super RAG に登録する
- 以降、頻出質問は FAQ が直接ヒットし、それ以外は元文書が受け止める
という循環が成立します。文書と FAQ の二層構造で知識ベースを構成する形です。
この構造の利点は、先にご覧いただいた比較表の「RAG の網羅性」と「FAQ の精度・安定性」を両取りできることにあります。
ストーリーの続き — Kさんの業務はどう変わったか
冒頭の Kさんに戻ります。FAQ Builder を使った後、何が変わったでしょうか。
最初の1回:3日間で80件
Kさんが最初に着手したのは、問い合わせの多いVPN・アカウント管理・共有フォルダ権限の3領域でした。関連する運用マニュアル計5本を対象に、FAQ 生成を実行します。
生成されたドラフトは約120件。ここからレビューに入ります。Kさんが実際にやったことは、
- 回答と根拠を突き合わせて確認する
- 明らかに不要なものを「不要」で落とす
- 表現を少し直す
- 古い記述に基づくものは「却下」して、後で文書側を直すリストに入れる
結果、80件が承認され、公開されました。作業時間は、他の業務の合間を使って実質3日。手作業で見積もっていた40時間超と比べると、大幅な短縮です。
副次的な発見:文書側の問題が見つかった
興味深かったのは、レビューの過程で文書側の問題が可視化されたことです。
- 3つの文書で、VPN 接続手順の記述が食い違っている
- ある手順書は、2年前に廃止されたシステムの前提で書かれている
- 権限申請のフローが、実際の運用と違っている
これらは、生成された FAQ に「矛盾の注記」が付いたことで気づけました。FAQ を作る過程が、文書の棚卸しにもなったわけです。Kさんはこれをきっかけに、文書の更新リストを作成しました。
日常の変化
公開から2か月後、定番の問い合わせは目に見えて減りました。すべてが消えたわけではありませんが、「まず FAQ を見てください」と案内できるようになったことが大きいとKさんは言います。
そして、対応の標準化も進みました。新人のBさんが対応するときも、FAQ を参照すればベテランと同じ回答ができます。これは、Kさんが当初想定していなかった効果でした。
残った仕事、増えた仕事
一方で、なくなった仕事ばかりではありません。FAQ のメンテナンスという新しい業務が生まれています。システムが更新されれば FAQ も見直しが必要ですし、新しい問い合わせパターンが出てくれば追加も必要です。
ただ、Kさんはこれを前向きに捉えています。ゼロから作るのと、既にあるものを直すのでは、負担がまったく違うからです。そして再生成の仕組みがあるので、大きな文書更新があったときは、また FAQ Builder を回せばよいのです。
【持ち帰り検討材料】FAQ 化候補文書の棚卸しシート
「うちにも FAQ 化すべき文書があるかもしれない」と思われた方に、実データなしで見当をつけるための簡易シートをご用意しました。
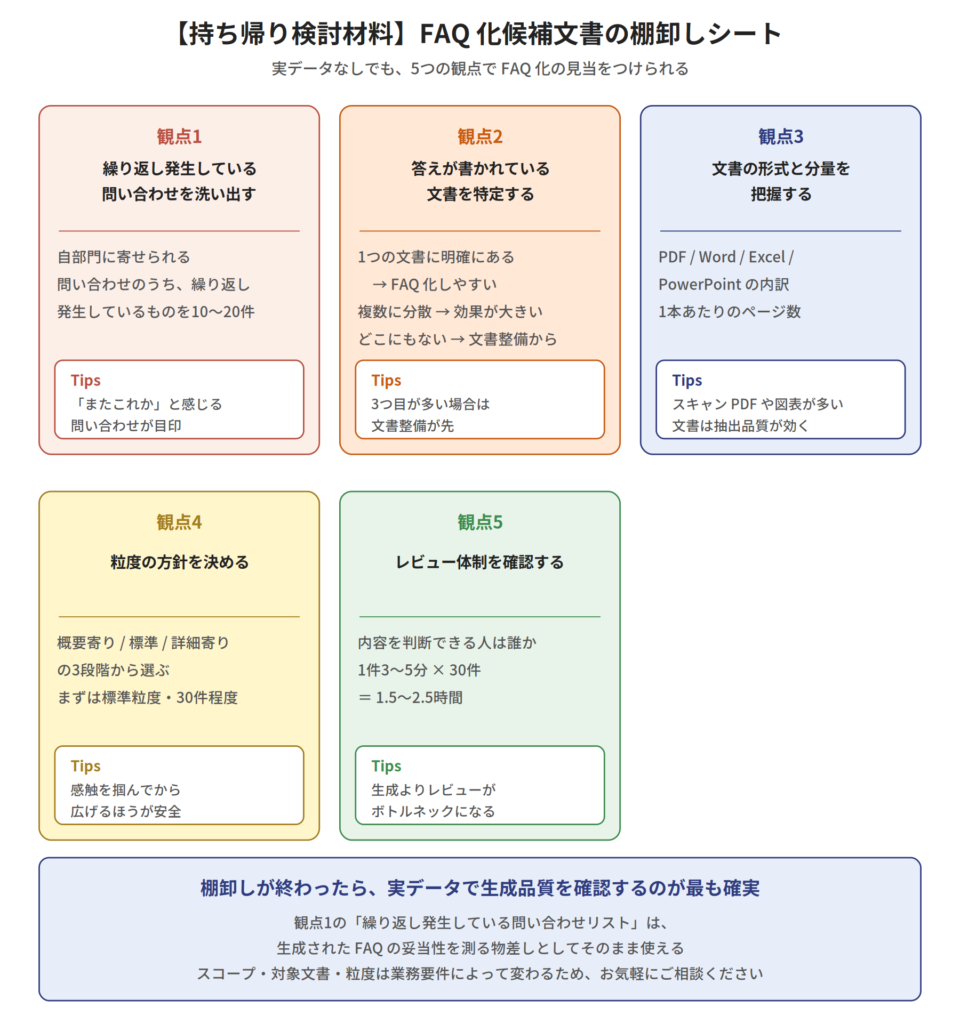
FAQ 化候補文書の棚卸しシート
5つの観点で、それぞれ「やること/確認ポイント/Tips」を押さえていきます。
観点1:繰り返し発生している問い合わせを洗い出す
まず、自部門に寄せられる問い合わせのうち、繰り返し発生しているものを10〜20件リストアップします。問い合わせ管理システムがあれば集計できますし、なければ担当者の体感でも構いません。
Tips:「またこれか」と感じる問い合わせが目印です。頻度の高い順に並べておくと、後の優先順位づけに使えます。
観点2:答えが書かれている文書を特定する
観点1で挙げた問い合わせについて、「答えはどの文書に書いてあるか」を確認します。ここで3つのパターンに分かれます。
- 1つの文書に明確に書いてある → FAQ 化しやすい
- 複数の文書に分散している → FAQ 化の効果が大きい
- どの文書にも書いていない → まず文書を整備する必要がある
Tips:3つ目のパターンが多い場合、FAQ 化の前に文書整備が必要です。この見極めが最初の分岐点になります。
観点3:文書の形式と分量を把握する
対象となりそうな文書が、どんな形式で、どれくらいの分量かを確認します。PDF・Word・Excel・PowerPoint、それぞれ何本ずつあるか。1本あたり何ページか。
Tips:スキャン PDF や、表・図の多い文書が含まれる場合、第4回でご紹介した抽出品質が効いてきます。この段階で把握しておくと、トライアルの設計がしやすくなります。
観点4:粒度の方針を決める
FAQ をどれくらいの細かさで作るかを、あらかじめ方針として決めておきます。
- 概要寄り:「この制度の目的は?」のような大きな問い。件数は少なく、入門向け
- 標準:「この手続きには何が必要?」のような実務的な問い。まずはここから
- 詳細寄り:「条件Xのときは何が違う?」のような例外条件まで。件数は増え、レビュー負荷も上がる
Tips:最初は標準粒度で、件数を30件程度に絞って試すのが安全です。感触を掴んでから広げるほうが、レビューの負担をコントロールしやすくなります。
観点5:レビュー体制を確認する
FAQ 化はレビューが前提です。誰がレビューするのか、どれくらい時間を割けるのかを確認しておきます。
- 対象領域の内容を判断できる人は誰か
- 1件あたり何分かけられるか
- 週に何時間確保できるか
Tips:生成そのものより、レビューがボトルネックになります。1件3〜5分として、30件なら1.5〜2.5時間。この見積もりを最初に持っておくと、無理のない計画が立てられます。
そして実データでの検証へ
棚卸しが終わったら、実際のデータで生成品質を確認するのが最も確実です。スコープ・対象文書・粒度といったパラメータは、業務要件によって最適な形が変わります。記事末尾のお問い合わせフォームからお気軽にご相談ください。
Tips:観点1〜5の結果を整理してお伝えいただくと、初回トライアルの設計が一気にスムーズになります。特に観点1の「繰り返し発生している問い合わせリスト」は、生成された FAQ の妥当性を判断する物差しとしてそのまま使えます。
次回予告
次回(第9回)は、ユースケース事例③ AIエージェント連携をお届けします。第2回でご紹介した Dify 連携の経費審査ワークフローを深掘りし、Super RAG をエージェント基盤と組み合わせたときに何ができるかを扱います。
第7回(文書 vs 文書検索)、第8回(FAQ 生成)と、いずれも Super RAG を部品として使う構成をご紹介してきました。第9回では、汎用のワークフロー基盤と組み合わせるという3つ目の形をご覧いただきます。自社でコードを書くのではなく、ノーコード/ローコードのエージェント基盤に Super RAG を組み込むアプローチです。
まとめ
第6回で「用語集を登録しておけば、Super RAGが自動的に効かせてくれる」とお伝えしました。本記事は、その先にある「では、誰がそれを作るのか」という問いへの答えです。
社内には文書があります。答えも書いてあります。それでも同じ問い合わせが繰り返されるのは、情報が不在だからではなく、情報への到達が難しいからです。FAQ 化はこの距離を縮める有効な手段ですが、手作業では1件30分〜1時間かかり、現実的に着手できない——これが多くの組織で起きている構造です。
FAQ Builder は、この準備コストを下げるためのアプローチです。質問生成・統合・代表質問整形・根拠収集・回答統合・ドラフト化という6フェーズに処理を分解し、それぞれで保守的な判断を積み重ねています。
設計を貫く思想は3つあります。根拠を捨てない(evidence-first)、全文を対象にする(検索に頼らず網羅性を優先し、コストは別手段で最適化)、そしてレビューを前提にする(完全自動化しないという判断)。いずれも、「FAQ を生成物ではなく、根拠を持った運用データとして扱う」という一点に集約されます。
生成された FAQ の出口は2つあります。既存の FAQ 管理ソフトへ投入する道と、Super RAG に登録し直して文書と FAQ の二層構造を作る道です。後者では、第4回でご紹介した FAQChunker が、まさにこの形式を得意とします。上流で整えた素材が、下流の仕組みで活きる——連載を通してお伝えしてきた構造が、ここでも成立しています。
そして、RAG と FAQ は競合しません。RAG は網羅性で、FAQ は頻出質問の精度と安定性で強い。頻出領域を FAQ が受け持ち、それ以外を RAG が受け止める——この二層構造が、実務的にはもっとも扱いやすい形だと考えています。
「うちにも FAQ 化すべき文書がありそうだ」と思われた方は、本記事の持ち帰り検討材料にある5観点の棚卸しをお試しください。そのうえで実データでの検証をご希望でしたら、記事末尾のお問い合わせフォームからお気軽にご相談ください。
<このシリーズの記事>
- 【第1回】通常のRAGでは届かない品質へ — Super RAGを支える技術的な工夫
- 【第2回】3つの組み込みパターン徹底解説 — API呼び出しフローとDify経費審査の解剖
- 【第3回】API機能カタログ — 何ができて、何は自社で担うか
- 【第4回】ドキュメント抽出の中身 — エンジンはどう選ばれているか
- 【第5回】ハイブリッド検索とリランク — 「意味」と「語」の両立で、抽出した中身を使い切る
- 【第6回】Super RAGの回答戦略 — Single-hopを極める設計判断と、回答品質を支える3つの工夫
- 【第7回】Super RAG API活用事例:「文書 vs 文書」の検索 — 作業計画書から過去の事故・ヒヤリハットを検索し、危険を予測する(2026年8月公開予定)